Tensorflow의 Dataset 사용법 정리
MinMaxScaler와 같이 사용할 때 마다 까먹는 Tensorflow의 Dataset사용법 정리!!
모델 학습을 위한 Dataset을 만들때 사용하는 Tensorflow의 Dataset기능 중 가장 자주 사용하는 용어에 대해 정리해볼 생각이다.
Tensorflow의 Dataset은 데이터를 모델학습에 최적화 시킨 구조로 변환 및 가공하는 효율적인 API이다.
개인적인 기준으로 빈번하게 사용하는 함수는 아래와 같다.
- from_tensor_slices()
- take()
- batch()
- repeat()
- shuffle()
위 나열된 5개의 기능이 각각 어떻게 작용하는지 코드와 출력문으로 기억과 이해하기 쉽게 정리해 둘 생각이다.
기본적으로 from_generator를 이용해서 tensorflow의 dataset format을 만들 수 있지만, 학습을 위해 data와 label을 나눌때 매우 편리하게 사용할 수 있는 from_tensor_slices를 이용해 dataset을 만들고 뒤에 함수들을 살펴보기로 하자.
from_tensor_slices & take
뒤에 계속 사용할 데이터구조를 만들겸 from_tensor_slices와 take에 대해 설명해보겠다.
import numpy as np
import pandas as pd
import tensorflow as tf

df = pd.DataFrame({'item1' : [1, 2, 3, 4, 5],
                    'item2' : [10, 20, 30, 40, 50],
                    'label' : ['a', 'b', 'c', 'd', 'e'] })

items = df[['item1','item2']]
labels = df['label']

## from_tensor_slices로 feature와 label을 아주 쉽게 매칭하고 데이터 구조를 설정 가능.
ts_dataset = tf.data.Dataset.from_tensor_slices((items, labels))

## take은 얼마만큼 tensor 개수를 가져올지 정한다.
## 아래의 경우 5개의 tensor를 가져온다는 뜻이다. 위 예제 dataframe의 경우 모두 다 가져온다.
for x, y in ts_dataset.take(5):
    print("#"*50)
    print(" feature : ", x)
    print("  labels : ", y)
아래 결과화면을 보면 좀더 직관적으로 ‘from_tensor_slices’가 어떻게 dataframe을 쪼개서 tensor뭉치를 만드는지 알 수 있다.
만약 위에 만든 데이터로 학습에 사용한다면, 입력 값(x)가 items 고 해당 라벨 값(y)가 labels가 되게 되고, 보통은 직접 slicing을 해서 사용하지만 ‘from_tensor_slices’는 더 쉽게 원하는 shape으로 학습 데이터 셋을 구성할 수 있다.
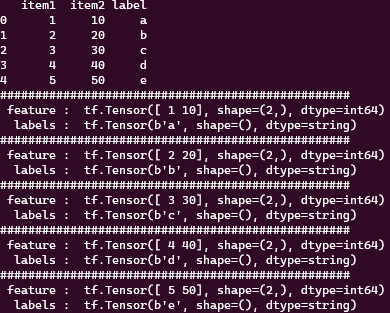
또한 take는 Dataset에서 element를 몇 개 가져올지를 정한다. 위 예제에서는 feature와 label 한 쌍이 element 하나이므로, take(5)는 다섯 쌍을 가져온다. batch() 뒤에 사용하면 배치 하나가 element 하나가 된다.
batch()
batch(int)는 입력된 int argument만큼 미니배치로 분할한다.
ts_dataset = tf.data.Dataset.from_tensor_slices((items, labels))
## 3개씩 tensor를 묶어서 미니배치를 생성.
ts_dataset = ts_dataset.batch(3)

for x, y in ts_dataset.take(5):
    print("#"*50)
    print(" feature : ", x)
    print("  labels : ", y)
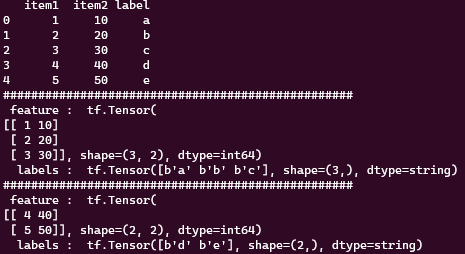
3개의 tensor를 1개의 batch로 묶는다. 여기서 batch란 학습에 입력될 때, 한번에 들어가는 양을 의미한다.
추가로 3개의 tensor끼리 묶었기 때문에 총 5개의 tensor를 가진 예제에선 3개 2개로 나눠서 총 2개의 batch가 생성되었다.
take(5)로 총 5개를 가져와야하지만 2개의 batch로 묶였기 때문에 2개의 출력문이 생성되었다.
repeat()
repeat()은 데이터셋을 반복해서 공급한다. repeat(2)처럼 횟수를 지정하면 두 번 반복하고, 인수를 생략하면 무한히 반복한다. 학습의 epoch 수를 알아서 맞춰 주는 기능은 아니라서, 무한 반복 Dataset으로 학습할 때는 steps_per_epoch처럼 한 epoch의 종료 조건도 정해줘야 한다.
ts_dataset = tf.data.Dataset.from_tensor_slices((items, labels))
## 3개씩 tensor를 묶어서 미니배치를 생성.
ts_dataset = ts_dataset.batch(3).repeat()

for x, y in ts_dataset.take(5):
    print("#"*50)
    print(" feature : ", x)
    print("  labels : ", y)
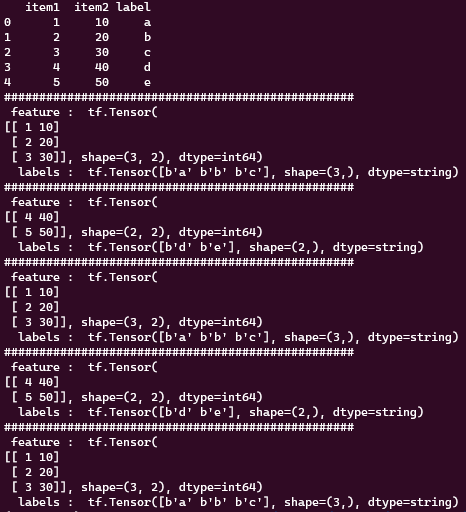
기존에 batch(3)을 이용해 5개의 tensor를 2개의 배치로 묶었을 땐, take(5)로 배치 수 보다 큰 수를 불러오게 하더라도 총 2개 밖에 출력되지 않았다. 하지만 repeat을 하게된다면 조건이 만족 할 때까지 반복해서 생성하고 출력하는 것을 볼 수 있다.
주의해야 할 점, repeat을 이용해 반복하는 와중 take으로 범위를 조건으로 주지 않으면 무한으로 데이터셋을 반복해서 불러온다.
여기서 repeat()과 batch()의 순서도 중요하다. 위 코드처럼 먼저 배치로 묶으면, 크기가 3인 배치와 2인 배치가 그대로 반복된다. 데이터를 먼저 반복한 뒤 묶으면 다음 반복의 데이터까지 이어서 크기가 3인 배치를 만들게 된다.
dataset = tf.data.Dataset.from_tensor_slices((items, labels))

for name, repeated in [
    ("batch then repeat", dataset.batch(3).repeat()),
    ("repeat then batch", dataset.repeat().batch(3)),
]:
    sizes = [int(x.shape[0]) for x, _ in repeated.take(5)]
    print(f"{name}: {sizes}")
batch then repeat: [3, 2, 3, 2, 3]
repeat then batch: [3, 3, 3, 3, 3]
💡 기존 post했던 LSTM shape 에서 data size%batch_size == 0 을 맞춰야 했던 건 stateful LSTM처럼 batch 크기가 고정된 모델일 때의 이야기다. 이런 모델은 나머지가 생겨 마지막 batch가 작으면 학습도중 에러가 발생한다. batch(batch_size, drop_remainder=True)로 작은 마지막 batch를 버릴 수 있지만, batch().repeat()만으로는 이 문제가 없어지지 않는다. 보통의 stateless LSTM은 마지막 batch가 작아도 학습할 수 있다.
stateful LSTM은 batch 크기만 맞추면 끝나는 것도 아니다. 다음 batch의 같은 위치에 이전 시퀀스의 이어지는 데이터가 와야 하므로, 무작정 repeat()으로 연결하거나 shuffle()로 순서를 섞으면 상태가 엉뚱한 시퀀스로 이어질 수 있다. 시퀀스 순서와 상태를 초기화할 시점도 같이 고려해야 한다.
shuffle()
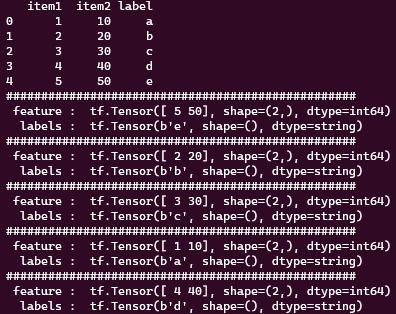
말그대로 데이터 셋을 무작위로 섞는다. 보통 shuffle(BUFFER_SIZE)의 형태로 사용하며 여기에서 ‘BUFFER_SIZE’는 섞기위해 사용되는 버퍼의 크기를 나타낸다. 일반적으로 ‘BUFFER_SIZE’는 데이터셋 보다 큰 값을 넣어 준다.
ts_dataset = tf.data.Dataset.from_tensor_slices((items, labels))
# Shuffle individual examples with a buffer of 10.
ts_dataset = ts_dataset.shuffle(10)

for x, y in ts_dataset.take(5):
    print("#"*50)
    print(" feature : ", x)
    print("  labels : ", y)
ts_dataset = tf.data.Dataset.from_tensor_slices((items, labels))
## 3개씩 tensor를 묶어서 미니배치를 생성.
ts_dataset = ts_dataset.shuffle(10).batch(3)

for x, y in ts_dataset.take(5):
    print("#"*50)
    print(" feature : ", x)
    print("  labels : ", y)
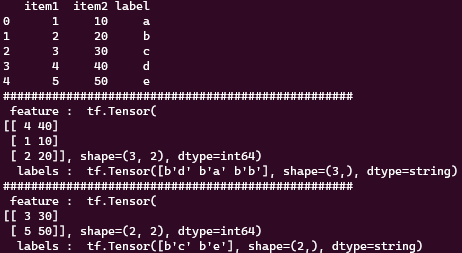
코드는 위에서부터 순서대로 실행하면 된다. 배치 순서 비교 출력은 TensorFlow 2.21.0에서 2026-10-12 실행했다. shuffle() 예제의 데이터 순서는 실행할 때마다 달라질 수 있다.
참고: TensorFlow Dataset API, Keras LSTM의 stateful 조건 — 2026-10-12 확인.