Python의 비밀! Python의 속도를 빠르게 만드는 방법
“코드가 92% 빨라진다”는 파이썬 속도 팁 7개 중 5개를 직접 재봤다. 2026년에 Python 3.14로 다시 재보니 set 멤버십은 2,000배 넘게, sum()은 4배쯤 빨랐고 나머지는 거의 차이가 없었다.
Corrected September 2026: Two conclusions in the original post were wrong. Tip 5’s “13× faster” came from timing five items once with
time.time(); measured properly withtimeit, the “optimized” version is about 2× slower. Tip 4 tested iteration, not membership;x in setis thousands of times faster thanx in list. All five tests were re-run on Python 3.14.2 and 3.12.13 (results at the end).
이번 포스트는 한가지 흥미로운 글을 읽고나서 글에서 제시한 예시들을 직접 시도해본 결과이다.
참고한 포스트에는 7가지 python의 속도를 향상시키는 방법을 소개했다.
Python Performance Hacks: 7 Ways to Speed Up Your Code by 92%
실험 방법은,
- 각 비교할 방법을 넣은 두 개의 함수를 만든다.
- 각 함수가 작동하면서 걸린 시간을 timeit 을 이용해 측정한다.
- 100번 정도 함수 호출을 반복해 평균 시간을 계산한다. (timeit의 number parameter를 이용)
- 시간을 비교한다.
어떻게 보면 허술한 실험 세팅이다. 하지만 제시한 방법이 ‘92% 속도 향상’ 이 사실 이라면, 나의 대충 실험에서도 그 성능이 보여질 것 같았다.
[만약 내 실험이 잘못되었다면, 지적해주시면 감사하겠습니다.]
천천히 글을 읽고 제시한 코드를 간단하게 따라하면서 속도의 차이를 비교해봤다. 아래는 그 7가지 중 5개 방법의 실험 결과이다. 나머지 두 개는 신기하긴 하지만 잘 안 쓸 것 같아서..
1. 내장 함수 사용
포스트에서의 설명 : Python의 내장 함수인 len(), sum(), range() 등은 성능을 최적화 하도록 설계되었으며, 자체 구현을 작성하는 것보다 빠를 수 있다. 왜냐하면 이들은 C를 이용해 구현되어있어서 동등한 Python 코드보다 빠르다.
my_list = [num for num in range(1, 10000)]

def run_slow(list_set):
    total = 0
    for num in list_set:
        total += num
    return total

def run_fast(list_set):
    return sum(list_set)

execution_time_slow = timeit.timeit(lambda: run_slow(my_list), number=100)
execution_time_fast = timeit.timeit(lambda: run_fast(my_list), number=100)

## 정수 10000까지의 숫자 list에서 각 component들의 합.
print(" w/ & w/o sum [built-in fcn]")
print(" Slow case : ", execution_time_slow, " sec")
print(" Fast case : ", execution_time_fast, " sec")
print(" Ratio : ", execution_time_slow/execution_time_fast)
print("-"*50)

def run_slow(list_set):
    max_value = my_list[0]
    min_value = my_list[0]
    for num in my_list:
        if num > max_value:
            max_value = num
        if num < min_value:
            min_value = num

    return max_value, min_value

def run_fast(list_set):
    return max(list_set), min(list_set)

execution_time_slow = timeit.timeit(lambda: run_slow(my_list), number=100)
execution_time_fast = timeit.timeit(lambda: run_fast(my_list), number=100)

## 정수 10000까지의 숫자 list중에서 min max값 찾기.
print(" w/ & w/o min, max [built-in fcn]")
print(" Slow case : ", execution_time_slow, " sec")
print(" Fast case : ", execution_time_fast, " sec")
print(" Ratio : ", execution_time_slow/execution_time_fast)
print("-"*50)
아래는 실행 결과이다.
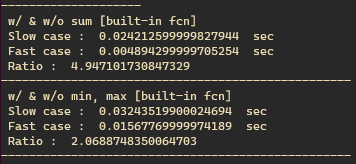
이건 놀랍기도 하면서 너무 예상되던 결과다. 물론 sum(), min(), max()와 같은 함수의 source code를 보면 원리는 많이 다르진 않을 것 같다. 하지만 빌드된 언어가 C이고 이미 최적화 되어있는 함수이므로 내가 호다닥 작성한 무식한 코드보다는 빠를 것이다. 결과가 말해주듯 sum()의 경우 약 5배, min, max의 경우 2배가량 속도 향상이 있었다.
(2026 추가) Python 3.14에서 다시 재보니 sum()은 여전히 4배쯤 빨랐는데, min/max는 오히려 루프가 더 빨랐다(0.8배).
max()와min()을 따로 부르면 리스트를 두 번 도는데 내 루프는 한 번에 둘 다 찾기 때문이다. 3.12에서는 1.1배로 내장 함수가 조금 빨랐다. 버전 따라 이 정도로 뒤집힌다.
2. 불필요한 계산 피하기
포스트에서의 설명 : 반복된 계산의 결과를 캐싱하고 불린 표현식에서 단락 평가를 사용하여 불필요한 계산을 피함으로써 성능을 향상시킬 수 있다.
솔직히 ‘불필요한 계산 피하기’의 내용은 잘 모르겠다. 이름만 보면 너무나 당연하고 지키기만 한다면 그 성능이 확실히 오를 것 같은 느낌이다. 하지만 글에서 제시한 예제 코드는 큰 의미 없는 구조로 보였다. 특히 첫 번째 예제인 caching은 예제 작성한 의미를 모르겠으므로 패스하겠다.
def run_slow(num):
    if num > 0 and num % 2 == 0:
        return True
    else:
        return False

def run_fast(num):
    if num <= 0 or num % 2 != 0:
        return False
    else:
        return True
execution_time_slow = timeit.timeit(lambda: run_slow(10), number=100)
execution_time_fast = timeit.timeit(lambda: run_fast(10), number=100)

print(" Using short-circuit evaluation")
print(" Slow case : ", execution_time_slow, " sec")
print(" Fast case : ", execution_time_fast, " sec")
print(" Ratio : ", execution_time_slow/execution_time_fast)
print("-"*50)
위의 예제는 ‘or’대신 ‘and’를 사용해서 두 개의 조건 중 첫 번째 조건만으로 결과를 확인 할 수 있게 해 ‘불필요한 계산’을 줄일 수 있고 속도 향상을 시킬 수 있다는 설명이다. 과연 그 결과는..
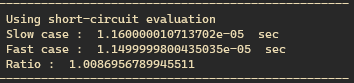
응~ 같아.
물론 조건이 위 예시와 같이 단순 비교처럼 간단하지 않거나 더 큰 resource를 사용한다면 차이가 있을 순 있겠다. 하지만 그 정도의 양 또는 복잡한 연산을 if에 조건 두 개를 넣고 사용하는 상황이 있을까 싶다.
3. for loop 에서 자주 사용하는 약식 표현식을 사용.
포스트에서의 설명 : 이들은 List와 Generator를 간결하고 효율적으로 생성하는 강력한 도구다. 특히 대규모 data-set을 처리할 때 전통적인 for loop를 사용하는 것보다 빠를 수 있다.
이건 해봐야 알 것 같았다. 약식으로 작성된 loop가 처음 python을 배울 때 작성한 for loop보다 얼마나 빠른지 감이 오지 않았다. python에서 for loop은 상당히 느리다고 배웠다. 왠만하면 많이 사용하지 말아야 한다고 알고있었기 때문에 기대가 되었다.
코드를 한번 봐보자.
def run_slow():
    my_list = []
    for num in range(1,100000):
        if num % 2 ==0:
            my_list.append(num)
    return my_list

def run_fast():
    my_list = [num for num in range(1, 100000) if num % 2 == 0]
    return my_list

execution_time_slow = timeit.timeit(lambda: run_slow(), number=100)
execution_time_fast = timeit.timeit(lambda: run_fast(), number=100)

print(" List Comprehensions")
print(" Slow case : ", execution_time_slow, " sec")
print(" Fast case : ", execution_time_fast, " sec")
print(" Ratio : ", execution_time_slow/execution_time_fast)
print("-"*50)
my_list 라는 비어있는 list에 1부터 십 만까지 숫자를 단순히 넣는 방식으로 시간을 계산했다. 중간에 if문을 추가해서 약간의 복잡성을 추가했다. 아래는 결과이다.
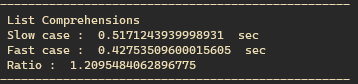
약식을 쓴 경우가 약 1.2배 빨랐다. 십 만까지 사용해 그렇게 빨리 끝나지도 않았고, 100번 반복 시행한 후 평균 값 이라, 결과가 단순 우연은 아닐 것이다. 즉 일반적인 for loop보다 약식이 어느 정도 속도 향상을 보이는 것은 맞는 이야기인 것 같다. 실제 프로젝트에서 20% 속도 향상은 꽤 크게 느껴지니 앞으로 틈틈히 사용 해야겠다.
(2026 추가) 3.12와 3.14에서는 차이가 4~9%로 줄었다. 파이썬 인터프리터가 일반 for loop도 빨라졌기 때문으로 보인다. 지금은 속도보다 읽기 편해서 쓰는 문법이라고 생각하는 게 맞겠다.
4. 적절한 데이터 구조 사용.
포스트에서의 설명 : 적절한 데이터 구조를 선택하는 것은 코드 성능에 중요한 영향을 미칠 수 있다. 예를 들어, Membership test에 list 대신 set를 사용하는 것이 훨씬 빠를 수 있다. set는 hash table 로 구현되기 때문.
우선 설명만 들어보면 나름 고개를 끄덕일 수 있다. 음 그럴 수 있지.. 하지만 해보고 싶었다. 그 차이가 어떻게 나타나는지 궁금했다.
my_list = [num for num in range(1, 10000)]
my_set = set(range(10000))

def run(lnput_item):
    count = 0
    for num in lnput_item:
        if num%3 == 0:
            count += 1
    return count

execution_time_slow = timeit.timeit(lambda: run(my_list), number=100)
execution_time_fast = timeit.timeit(lambda: run(my_set), number=100)

print(" Use the right data structures")
print(" Slow case : ", execution_time_slow, " sec")
print(" Fast case : ", execution_time_fast, " sec")
print(" Ratio : ", execution_time_slow/execution_time_fast)
print("-"*50)
위와 같이 list와 set을 생성 후 각 1부터 만까지 숫자를 넣었다. 단순한 계산으로 moduler operator(나머지 연산자)를 넣어서 3으로 나누었을 때 나머지가 0일 경우만 숫자를 센다. 아래는 실험 결과이다.
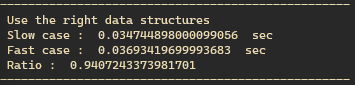
내가 실험 설계를 잘 못한 것 같다는 기분이 든다. 참고한 포스트에서는 set으로 사용할 때 속도가 더 빨라진다고 했는데… 아마 내가 단순한 membership test를 하지 않고 뭔가 연산을 해서 그런 것일 수도 있겠다. 더 나은 실험 설계가 있는지 다른 방식으로 도전해 봐야겠다.
아무튼 결과는 set의 경우가 6% 느려졌다.
(2026 추가) 실험 설계가 잘못된 게 맞았다. 위 코드는 처음부터 끝까지 순회하는 거라 list나 set이나 비슷하다(다시 재봐도 set이 0.91배). set이 빠른 건
9999 in my_set같은 멤버십 검사다. list는 앞에서부터 하나씩 비교하고, set은 해시로 바로 찾는다. 이걸로 재보니 Python 3.14에서 약 2,300배 차이가 났다(10,000번 검사에 list 0.456초, set 0.0002초).
5. 불필요한 함수 호출 피하기
포스트에서의 설명 : Python에서 함수 호출은 상대적으로 비용이 많이 들 수 있다. 특히 함수가 동적으로 조회 되어야 할 때 조심해야 한다. 코드를 최적화 하려면 함수 호출 횟수를 최소화하려고 노력 해보자.
말해 뭐하나. 지당하신 말씀이다. ‘불필요한 연산 피하기’의 확장 버전이다. 함수를 호출 한다는 것은 함수 내부에 있는 연산 전부를 수행한다는 뜻이므로, 어쩌면 ‘불필요한 연산’의 경우 보다 시간이 길어질 수 있다.
print(" Avoid excessive function calls")
def my_function(num):
    return num*num
import time
s_t = time.time()
my_list = [1, 2, 3, 4, 5]
total = 0
for num in my_list:
    total += num * my_function(num)

e_t = time.time()
execution_time_slow = e_t-s_t
print(" Slow case : ", execution_time_slow, " sec")

# With optimization

s_t = time.time()
my_list = [1, 2, 3, 4, 5]
total = 0
results = [my_function(num) for num in my_list]
for num, result in zip(my_list, results):
    total += num * result

e_t = time.time()
execution_time_fast = e_t - s_t
print(" Fast case : ", execution_time_fast, " sec")
print(" Ratio : ", execution_time_slow/execution_time_fast)
print("-"*50)
이번엔 함수를 만들어서 함수 호출로 계산하지 않고 예제 그대로 따라해봤다. 연산 시간은 ‘time’ 함수를 이용했다.
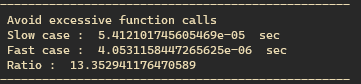
결과는 optimized된 방식이 계속 호출하는 방식보다 무려 13배 빨랐다.
여기서 나는 한 가지 궁금증이 생겼다. 위 예제는 my_list안에 5개의 원소만 넣어둔 상태로 진행했다. 즉 list 의 size가 작다. 만약 극단적으로 키운다면 연산 속도가 어떻게 변할까..
그래서 my_list를 10000 까지 채워서 진행해보았더니 결과는,
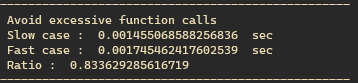
아무래도 optimization의 경우 ‘results’를 미리 계산하기 위해 loop를 한번 더 도는 셈이 되니, list양이 많아 질 수록 중첩되는 효과가 일어나서 더 느려지는 결과를 보여주는 것 같다.
(2026 추가) 위의 “13배”는 틀린 결과였다. 원소 5개짜리를
time.time()으로 딱 한 번 재서, 첫 실행 때 드는 준비 시간이 그대로 섞였다.timeit으로 여러 번 반복해서 재니 원소 5개일 때도 “최적화” 쪽이 0.47배, 즉 2배쯤 느렸다(10,000개에서는 0.68배). 함수 호출 횟수는 똑같고 리스트를 하나 더 만들 뿐이니 당연한 결과다. 함수 호출을 정말 줄이려면num * num * num처럼 함수를 안 부르고 바로 계산하면 되고, 이건 1.3~1.5배 빨랐다.
나머지 tip에 대한 간단 정리.
- 계산이 많은 코드에 Cython 또는 Numba 사용: Cython은 C로 컴파일되는 Python의 상위 집합이며, Numba는 Python 코드를 기계 코드로 컴파일할 수 있는 즉시 컴파일러이다. 두 도구 모두 계산이 많은 코드의 성능을 크게 향상시킬 수 있다.
- 프로파일링을 사용하여 성능 병목 현상 식별: 프로파일링은 코드 성능을 측정하고 가장 많은 시간을 차지하는 부분을 식별하는 기법이다. Python에는 cProfile과 profile과 같은 내장 프로파일링 도구가 있다. 이를 사용하여 코드의 느린 부분을 식별하고 최적화 할 수 있다.
결론.
- 가능하다면 Python 내장함수를 열심히 사용하자
- for loop는 무겁다. 약식 사용에 익숙해 지자.
확실히 python의 속도를 올릴 수 있는 좋은 팁 들이 있었고, 각 팁마다 비교해 볼 수 있는 코드 아이디어를 제시해줘서 이해하기 편했다. 그 중에는 의미를 이해하기엔 좀 더 공부가 필요한 팁도 있었고, 몇개는 그 차이를 몸소 느낄 수 있었다. 확실히 느낀 점은 python - for loop는 정말 무겁다.
2026년에 다시 재보기 (Python 3.14.2 / 3.12.13)
3년 만에 다시 보니 틀린 결론이 두 개 있었다(위 (2026 추가) 참고). 이번엔 제대로 재려고 방법을 바꿨다.
time.time()한 번이 아니라timeit.repeat으로 5번 재서 가장 빠른 값을 쓴다. 다른 프로그램 때문에 느려진 값을 빼기 위해서다.- ④는 원래 글의 주장대로 멤버십 검사(
in)를 추가했다. - ⑤는 함수를 아예 안 부르는 버전(inlined)을 추가했다.
import sys
import timeit

print("Python", sys.version.split()[0])


def compare(title, slow, fast, number=100):
    s = min(timeit.repeat(slow, number=number, repeat=5))
    f = min(timeit.repeat(fast, number=number, repeat=5))
    print(f"{title:32s} slow {s:.5f}s  fast {f:.5f}s  ratio {s / f:.2f}")


my_list = [num for num in range(1, 10000)]
my_set = set(range(10000))


def sum_loop(xs):
    total = 0
    for num in xs:
        total += num
    return total


def minmax_loop(xs):
    max_value = min_value = xs[0]
    for num in xs:
        if num > max_value:
            max_value = num
        if num < min_value:
            min_value = num
    return max_value, min_value


def loop_append():
    out = []
    for num in range(1, 100000):
        if num % 2 == 0:
            out.append(num)
    return out


def count_div3(items):
    count = 0
    for num in items:
        if num % 3 == 0:
            count += 1
    return count


def my_function(num):
    return num * num


compare("1a. sum() vs loop", lambda: sum_loop(my_list), lambda: sum(my_list))
compare("1b. min()/max() vs loop", lambda: minmax_loop(my_list), lambda: (max(my_list), min(my_list)))
compare("2. and vs or (num=10)",
        lambda: 10 > 0 and 10 % 2 == 0, lambda: not (10 <= 0 or 10 % 2 != 0), number=100000)
compare("3. comprehension vs append", loop_append, lambda: [n for n in range(1, 100000) if n % 2 == 0])
compare("4a. iterate: list vs set", lambda: count_div3(my_list), lambda: count_div3(my_set))
compare("4b. 9999 in list vs in set", lambda: 9999 in my_list, lambda: 9999 in my_set, number=10000)

for n in (5, 10000):
    xs = list(range(1, n + 1))

    def direct():
        total = 0
        for num in xs:
            total += num * my_function(num)
        return total

    def precomputed():
        total = 0
        results = [my_function(num) for num in xs]
        for num, result in zip(xs, results):
            total += num * result
        return total

    def inlined():
        total = 0
        for num in xs:
            total += num * num * num
        return total

    number = 2000 if n == 5 else 100
    compare(f"5a. n={n} direct vs precomputed", direct, precomputed, number)
    compare(f"5b. n={n} direct vs inlined", direct, inlined, number)
Python 3.14.2, Apple M5에서 2026-09-30에 돌린 결과:
Python 3.14.2
1a. sum() vs loop                slow 0.00740s  fast 0.00193s  ratio 3.84
1b. min()/max() vs loop          slow 0.00945s  fast 0.01155s  ratio 0.82
2. and vs or (num=10)            slow 0.00197s  fast 0.00186s  ratio 1.06
3. comprehension vs append       slow 0.17888s  fast 0.17246s  ratio 1.04
4a. iterate: list vs set         slow 0.01321s  fast 0.01446s  ratio 0.91
4b. 9999 in list vs in set       slow 0.45589s  fast 0.00019s  ratio 2340.91
5a. n=5 direct vs precomputed    slow 0.00028s  fast 0.00059s  ratio 0.47
5b. n=5 direct vs inlined        slow 0.00026s  fast 0.00018s  ratio 1.47
5a. n=10000 direct vs precomputed slow 0.02974s  fast 0.04403s  ratio 0.68
5b. n=10000 direct vs inlined    slow 0.02969s  fast 0.02271s  ratio 1.31
ratio가 1보다 크면 “fast” 쪽이 정말 빠른 것이고, 1보다 작으면 오히려 느린 것이다.
| 팁 | 2023년 (내 첫 실험) | 2026년 3.14 (2회) | 2026년 3.12 |
|---|---|---|---|
| ① sum() | 약 5배 | 3.8~4.5배 | 4.3배 |
| ① min()/max() | 약 2배 | 0.8배 (느림) | 1.1배 |
| ② and / or 순서 | 차이 없음 | 0.8~1.1배 (돌릴 때마다 바뀜, 차이 없음) | 0.97배 |
| ③ list comprehension | 1.2배 | 1.04~1.06배 | 1.09배 |
④ set 멤버십 (in) | (재지 못함) | 약 2,000~2,300배 | 약 1,100배 |
| ⑤ 결과 미리 계산 (원소 5개) | 13배 (잘못 잰 값) | 0.45~0.47배 (느림) | 0.50배 |
| ⑤ 함수 호출 없애기 (원소 5개) | — | 1.4~1.5배 | 1.8배 |
(위 출력은 3.14 첫 번째 실행. 표의 3.14 칸은 두 번 돌린 범위, 3.12는 한 번.)
다시 정리하면,
- 확실한 건 두 개다.
sum()같은 내장 함수는 루프보다 4배쯤 빠르고, “들어 있나?”를 자주 확인하면 list 대신 set을 쓴다. - list comprehension은 이제 속도 차이가 거의 없다. 읽기 편해서 쓰면 된다.
- 결과를 미리 계산해 둔다고 빨라지지 않는다. 함수 호출을 줄이려면 호출 자체를 없애야 한다.
- 가장 크게 배운 건 재는 방법이다. 5개짜리를 한 번 재면 13배라는 엉뚱한 숫자가 나온다.
timeit으로 여러 번 재야 한다.